Wie sich Bloggenerierung für Marketingteams skalieren lässt
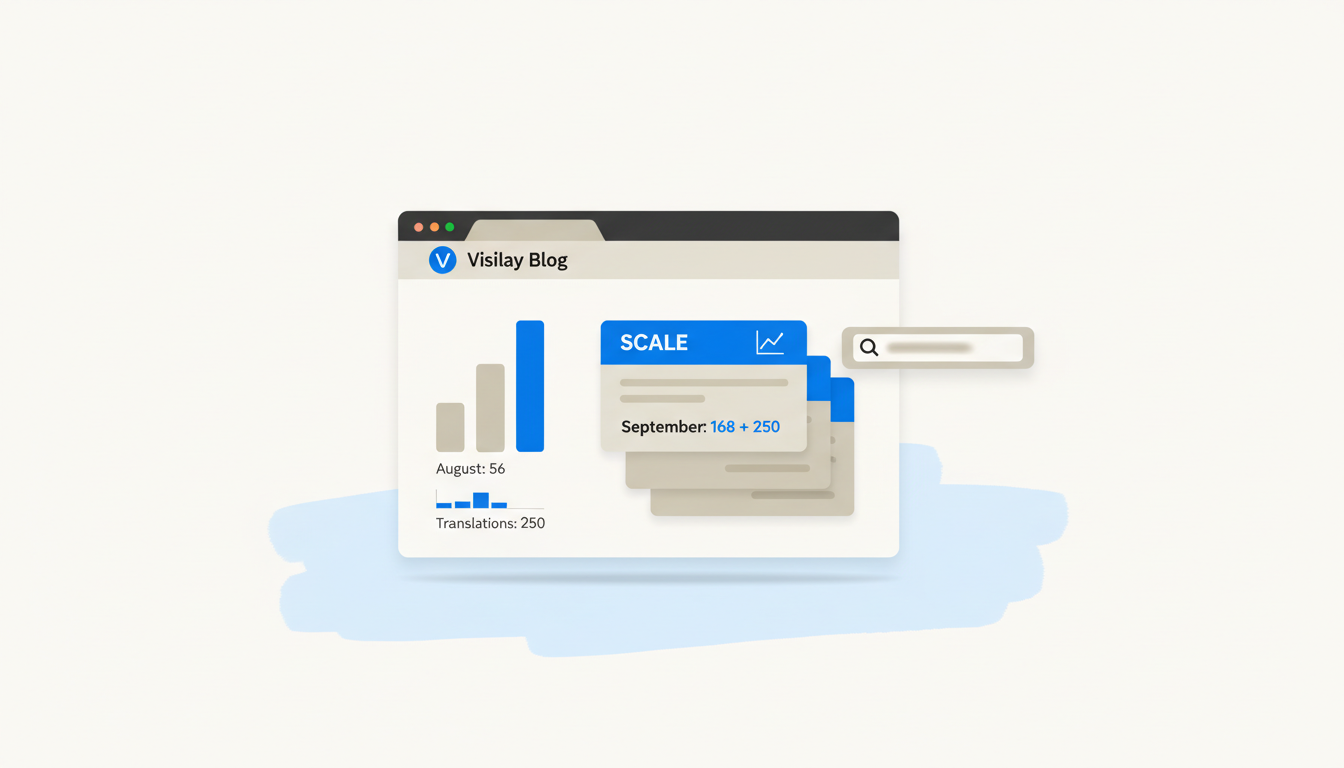
Im September 2026 haben einige Teams gezeigt, dass Skalierung keine Theorie ist: Visilay meldete 56 Artikel im August und 168 im September, zusätzlich 250 englische Übersetzungen — ein eindeutiges Signal, dass moderne Bloggenerierungs-Workflows die Produktion deutlich ankurbeln können, wenn Governance und Tools stimmen.
Wie Blogdat die automatisierte Pipeline zusammenfügt
| Setup in einem Satz |
|---|
| Blogdat verbindet Topic Research, ein evidenzbasiertes Briefing, AI-Drafting, Hero-Image-Erstellung, geplante Veröffentlichung und automatische Google-Einreichung in einem einzigen Dashboard für Multi-Site-Teams. |
Dieser Satz muss genauer erklärt werden, denn Ihr Team lebt in den Details: Die Themenfindung identifiziert Lücken auf Portfolio-Ebene; ein automatisiertes Briefing füllt Zielgruppe, Bewertungskriterien und Produkthintergrund evidenzbasiert aus; der Entwurf wird mit Lokalisierungsschichten erstellt; ein markenkonformes Hero-Image wird gerendert (mit Stock-Fallback); Posts werden geplant und automatisch bei Google eingereicht, um die Indexierung und KI-Entdeckung zu beschleunigen. Die Redaktion behält die Redaktionswarteschlange als Single Source of Truth und überwacht Site-Readiness-Scores, bevor Inhalte live gehen.
Was in einem Dashboard-Lauf passiert (und wo manuell eingegriffen wird)
Thema auswählen, Coverage prüfen, Briefing erstellen, Entwurf und Bild erzeugen, zur Veröffentlichung in Warteschlange stellen und dann bei Google einreichen — mit klar definierten Freigabe-Gates an zwei Stellen.
Ein einzelner Agent-Lauf im Blogdat-Dashboard sieht so aus:
- Thema auswählen: Der automatisierte Topic-Engine schlägt Ideen über das Portfolio vor und markiert Duplikate.
- Coverage Check: Sitespezifische Regeln verhindern Wiederveröffentlichungen und markieren Sprachen für die Lokalisierung.
- Blueprint erstellen: Das Briefing füllt automatisch Zielgruppe, Intent, Bewertungskriterien und Review-Datum (die evidenzbasierte SALP-SEO-Methode).
- Entwurf + Bild: AI erstellt den Beitrag und ein markenkonformes Hero-Image; SEO-Readiness und Formatierungs-Templates werden angewendet.
- Warteschlange & Freigabe: Inhalt wird mit Approval-Ticket in die Queue gestellt; ein menschlicher Reviewer erhält eine kurze Checkliste vor Veröffentlichung.
- Veröffentlichen & Einreichen: Blogdat postet wie geplant auf den verbundenen Sites und reicht automatisch bei Google ein, um die Indexierung zu beschleunigen.
Die Übergaben an Menschen sind klar definiert. Sie entscheiden, welche Rollen den finalen Freigabeknopf drücken dürfen und wer nur kommentieren kann. Signale im Dashboard zeigen SEO-Readiness-Score, Zeit-zur-Review-SLA und ob Produkthintergrund angehängt wurde. In der Praxis ist ein 10-minütiges Human-Review der Sweet Spot, den viele Teams nach LOW/CODE und Ahrefs-Guidance wählen: schnell genug für hohen Durchsatz, lang genug, um Faktenabweichungen zu erkennen.
Fehlerquellen, die Sie sehen werden, und Blogdat-Kontrollen, die sie stoppen
| Häufiges Problem (Kurzfassung) |
|---|
| Erfundene Strukturen, Keyword-Stuffing, Formatierungsabweichungen und Faktenfehler sind wiederkehrende öffentliche Fehler — diese lassen sich durch gutes Design vermeiden. |
- Erfundene Strukturen — AI kann Strukturen hervorbringen, die plausibel wirken, aber nicht zum Suchintent passen. Blogdat verhindert das durch Briefing-Constraints: Pflichtüberschriften, verlinkte Evidenzfelder und eine kurze "Must Cover"-Liste, die im Entwurf belegt werden muss.
- Keyword-Stuffing — manche Workflows setzen Dichte über Nutzwert. Der SEO-Readiness-Score detektiert Überoptimierung und schlägt intent-synonyme Alternativen statt Wiederholungen vor.
- Formatierungsabweichungen — wenn viele Agenten für diverse Sites schreiben, driftet HTML und Struktur auseinander. Blogdat nutzt sitespezifische Formatierungsvorlagen und eine Beitragsvorschau, die das finale CMS-Markup vor der Planung zeigt.
- Faktenfehler — automatisches Drafting ohne Evidenzbasis ist fehleranfällig. Das evidenzbasierte Briefing verlangt Produkt- oder Datenquellen und bindet diese an eine Review-Checkliste; der Reviewer muss die Evidenz vor der finalen Veröffentlichung als geprüft markieren.
Dieser Aufbau ist kein Hexenwerk. Er verschiebt Fehlerquellen von "unvorhersehbar schlechten Beiträgen" zu "systematischer Review-Arbeit". Das ist ein Kompromiss, den Teams akzeptieren sollten.
Zeit, Kosten und operationale Kompromisse
Brief-Erstellung, die früher 30–60 Minuten dauerte, kann mit AI-Unterstützung auf etwa 2–3 Minuten sinken; mit einem humanen Review-Benchmark von 8–12 Minuten pro Veröffentlichung, wenn man sicheren Durchsatz erzielen will.
Im operativen Bereich müssen Sie Review-Zeit und Durchsatz messen, so dass Automatisierung Arbeit reduziert statt nur verschiebt. Tracken Sie drei KPIs in Blogdat: Zeit für Brief-Generierung, Reviewer-Zeit pro Veröffentlichung und Review-Durchsatzrate. Steigt die Reviewer-Zeit, während die Brief-Zeit sinkt, verlagern Sie Aufwand statt ihn zu senken.
Wie man diese Zahlen misst
Nutzen Sie das Dashboard, um Zeitstempel für Brief-Erstellung, Reviewer-Zuweisung, ersten Durchgang und finale Freigabe zu protokollieren. Legen Sie Alarme an, wenn der durchschnittliche Review-Zeitraum Ihre SLA überschreitet.
Das Ganze bricht zusammen, wenn Teams den Umfang nicht limitieren: Vollautomatisierte Abläufe bei risikoreichen Produktbehauptungen oder juristischen Inhalten erzeugen Nacharbeit. Reservieren Sie Full-Automation für weniger riskante Inhalte und behalten Sie für risikoreiche einen menschzentrierten Prozess.
Was automatisieren und was manuell lassen
Nicht jeder Beitrag sollte gleich behandelt werden. Entscheiden Sie nach Wiederholbarkeit und Risiko.
- Automatisieren Sie wiederholbare Templates: lokale How-to-Guides, Release Notes, standardisierte Produktzusammenfassungen und übersetzte Evergreen-Posts.
- Hybrid-Workflow für variablen Content: Case Studies, Original Research oder alles, was einzigartige Daten zitiert — Agententwurf, humanes Editieren, dann Veröffentlichung.
- Manuell behalten: Thought Leadership, rechtlich anspruchsvolle Beiträge und Interviews.
Operative Regeln zur Durchsetzung über ein zentrales Dashboard: redaktionelle Warteschlangen-Sperren für geplante Kampagnen, separate Pipelines/Tags für Agenten- vs. Human-Content und SLAs für Review (Beispiel: 2–3 Minuten Brief-Generierung; 10 Minuten Reviewer-Ziel; wöchentliche QA-Stichprobe von 5 % Agenten-Posts).
Signale, Tempo und kurze Checkliste für den Pilotstart
Nutzen Sie die Evidenz aus 2026, um realistische Erwartungen zu setzen: Visilays Produktionsraten im August-September zeigen, dass Sie Hunderte Posts erreichen können, sie veröffentlichten aber auch Übersetzungen und markierten Stellen, an denen Menschen eingreifen mussten. Die Visilay-Workflow finden Sie mit konkreten Takt- und Zahlenbeispielen in ihrem Blog.
| Tempovorgabe |
|---|
| Starten Sie mit 1–3 Agentenposts pro Site und Woche, validieren Sie die Indexierung durch Auto-Submission, skalieren Sie dann auf täglich, wenn Review-SLAs und Qualitätsmetriken stabil sind. |
- Checkliste für den Pilot: Freigabe-gesteuerte Pipeline vorhanden; Blueprint-Templates bereit; Metrik-Dashboard protokolliert Brief- und Review-Zeit; Portfolio-Sites als Agenten-Content markiert.
- Erwarteter Indexierungseffekt: Automatische Google-Einreichung verkürzt das Entdeckungsfenster und hilft AI-Modellen, neue Inhalte schneller zu erkennen — Blogdat’s Auto-Submit spart viele manuelle Schritte.
FAQ — schnelle Antworten für das Montag-Stand-up
Ist automatisches Veröffentlichen sicher? Nicht ohne Freigabe-Gates. Nie darf AI ohne menschliche Validierung bei Fakten oder rechtlichem Risiko veröffentlichen; Ahrefs und andere Experten empfehlen ausdrücklich diesen Schutz (Ahrefs).
Wie messe ich ROI und Reviewer-Zeit? Messen Sie Zeitersparnis bei Briefs, Reviewer-Minuten pro Veröffentlichung, Ranking-Deltas und organischen Traffic pro Beitrag. LOW/CODE und SALP SEO zeigen, dass man mit einem ausgereiften Briefsystem die Brief-Erstellung von 30–60 Minuten auf wenige Minuten reduzieren kann (LOW/CODE, SALP SEO).
Wie trenne ich Agenten- von Human-Content? Markieren Sie Beiträge bei Erstellung, zeigen Sie separate Portfolio-Ansichten und veröffentlichen Sie mit unterschiedlichen Autorenlabels. Halten Sie experimentelle Agentenläufe in einer Sandbox-Site oder einem klar gekennzeichneten Kanal, bis das Team der Pipeline vertraut.
Eine chaotische Situation, die Sie erwarten sollten: Montags-Stand-up, bei dem ein PM die redaktionelle Warteschlange öffnet und ein halbes Dutzend Auto-Entwürfe für Sites mit dünnem Content sieht — hier brauchen Sie die redaktionelle Sperre, um zu pausieren und neu zuzuweisen. In diesem Moment sind Policies wichtiger als Tools.
Limitierungen: Skalierte Bloggenerierung scheitert weiterhin, wenn Ihre Inhalte von exklusiven Daten oder Interviews abhängen oder wenn Sie Domain Expertise durch oberflächliche Entwürfe ersetzen wollen. Automatisierung beschleunigt Volumen; Governance sichert Qualität.
Lesen Sie auch How to Generate SEO-Ready Blogs with AI and Auto-Index und How to auto submit blog to google and get it indexed faster.
